Gemini Embedding 2: khi AI tìm kiếm được cả hình ảnh, âm thanh và video
Tìm hiểu Gemini Embedding 2: không gian vector đa phương thức, ứng dụng RAG, giới hạn đầu vào, giá API và cách triển khai Python đúng chuẩn tài liệu Google.
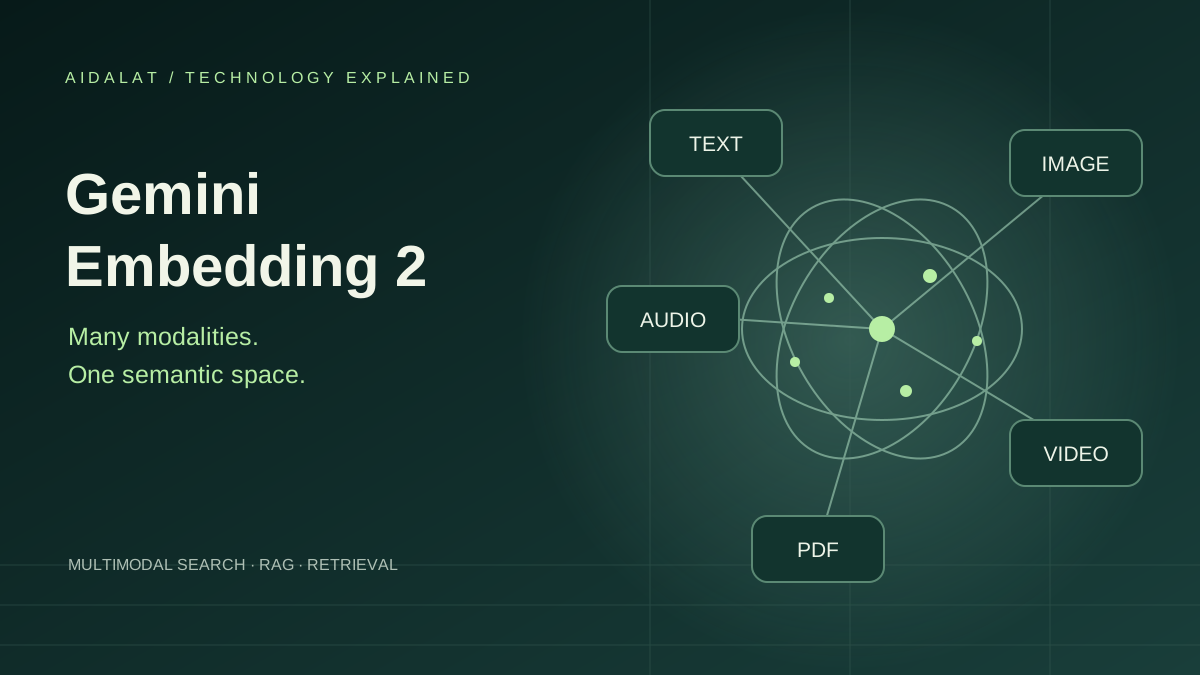
- ✓ Gemini Embedding 2 đưa văn bản, ảnh, audio, video và PDF vào cùng một không gian vector, mở đường cho tìm kiếm xuyên loại dữ liệu.
- ✓ Model ổn định là gemini-embedding-2: tối đa 8.192 token đầu vào, vector mặc định 3.072 chiều và có thể điều chỉnh để giảm dung lượng.
- ✓ Video không được xử lý track âm thanh; nâng cấp từ gemini-embedding-001 phải tạo lại toàn bộ embedding, không chỉ đổi tên model.
Bạn có một kho tài liệu gồm bài viết, slide PDF, ảnh sản phẩm và video hướng dẫn. Người dùng hỏi: “Tìm đoạn có thao tác lắp linh kiện giống hình này.” Tìm theo từ khóa sẽ khó xử lý nếu video chưa có mô tả, còn tên file chỉ là một mã số.
Gemini Embedding 2 hướng tới kiểu bài toán đó: chuyển nhiều loại dữ liệu thành các vector có thể so sánh trong cùng một không gian ngữ nghĩa. Google mô tả đây là mô hình embedding đa phương thức đầu tiên trong Gemini API, hỗ trợ hơn 100 ngôn ngữ.[3]
Điểm đáng chú ý không phải AI có thêm một chatbot. Đó là việc lớp tìm thông tin bên dưới chatbot, kho tri thức và ứng dụng tìm kiếm có thể làm việc trực tiếp với nhiều định dạng hơn.
Phạm vi: Bài phân tích dựa trên tài liệu Google được đối chiếu ngày 06/10/2026. Các tình huống ứng dụng và kiến trúc đề xuất là minh họa của AIDaLat, không phải kết quả benchmark do chúng tôi đo. Mã Python bên dưới là hướng dẫn theo API chính thức, không kèm kết quả suy luận được giả lập.
1. Trước hết, đừng nhầm Gemini Embedding 2 với EmbeddingGemma
Hai tên gần nhau nhưng phục vụ hai hướng triển khai khác nhau:
- Gemini Embedding 2: mô hình qua Gemini API, nhận văn bản, hình ảnh, video, âm thanh và PDF để tạo embedding.[3]
- EmbeddingGemma: mô hình embedding văn bản đa ngôn ngữ 308 triệu tham số, dựa trên Gemma 3, có trọng số mở và được tối ưu cho thiết bị như điện thoại, laptop, tablet.[2]
Nói ngắn gọn: nếu muốn lớp tìm kiếm đa phương thức qua dịch vụ Google, tìm hiểu Gemini Embedding 2. Nếu ưu tiên embedding văn bản chạy cục bộ, cân nhắc EmbeddingGemma. Không nên dùng tên “Embedding Gemma 2” để gọi lẫn hai dòng này.
Gemini Embedding 2 cũng không còn chỉ là một thử nghiệm preview: bài Google Developers Blog ngày 30/04/2026 xác nhận model đã đạt General Availability, và tài liệu hiện liệt kê mã ổn định gemini-embedding-2.[1][3]
2. Embedding là gì, và đa phương thức thay đổi điều gì?
Một embedding là dãy số biểu diễn nội dung đầu vào. Ứng dụng dùng độ tương tự giữa những vector này để tìm nội dung liên quan, phân nhóm hoặc phân loại; đây là các tác vụ được Google liệt kê cho API embedding.[3]
Có thể hình dung embedding như một tọa độ ngữ nghĩa, nhưng không nên hiểu nó là bản sao đầy đủ của tài liệu. Vector giúp chọn ứng viên liên quan; khi cần kiểm chứng, ứng dụng vẫn phải quay lại nội dung gốc.
Với một hệ thống chỉ có embedding văn bản, nhóm phát triển thường phải chuyển ảnh thành caption hoặc audio thành transcript trước khi tìm kiếm. Gemini Embedding 2 cho phép các loại dữ liệu khác nhau cùng được ánh xạ vào một không gian, hỗ trợ tìm kiếm và so sánh xuyên phương thức.[3]
Ví dụ minh họa:
- Nhập câu “chiếc áo khoác xanh có khóa kéo” để tìm ảnh sản phẩm phù hợp.
- Dùng một ảnh làm truy vấn để tìm nội dung có đặc điểm thị giác liên quan.
- Tìm các clip hoặc trang PDF liên quan đến câu hỏi, rồi đưa nội dung tìm được cho mô hình sinh câu trả lời.
Lợi ích kiến trúc là giảm nhu cầu ghép nhiều model embedding riêng biệt. Tuy nhiên, không gian chung không đồng nghĩa mọi truy vấn đều chính xác. Chất lượng vẫn cần được đo trên dữ liệu và ngôn ngữ của ứng dụng.
3. Thông số và giới hạn cần biết trước khi xây dựng
Theo tài liệu Gemini API hiện tại, giới hạn tổng đầu vào là 8.192 token; từng loại dữ liệu còn có giới hạn riêng.[3]
| Loại dữ liệu | Giới hạn được công bố |
|---|---|
| Văn bản | Tối đa 8.192 token |
| Hình ảnh | Tối đa 6 ảnh/request; PNG, JPEG |
| Âm thanh | Tối đa 180 giây; MP3, WAV |
| Video | Tối đa 120 giây; MP4, MOV; codec H264, H265, AV1, VP9 |
| Tối đa 1 file/request, không quá 6 trang | |
| Vector đầu ra | 128–3.072 chiều; Google khuyến nghị 768, 1.536 hoặc 3.072 |
Hai chi tiết dễ bỏ sót: video được xử lý tối đa 32 khung hình. Clip dài không quá 32 giây được lấy mẫu 1 fps; clip dài hơn được lấy mẫu đều thành 32 khung hình. Ngoài ra, track âm thanh trong file video không được xử lý.[3]
Điều này ảnh hưởng trực tiếp đến sản phẩm. Nếu cần tìm theo lời nói trong video, không nên chỉ gửi MP4 rồi cho rằng hệ thống đã nghe toàn bộ hội thoại. Đề xuất thực dụng là tách audio thành một nguồn riêng, chia đoạn và lưu mốc thời gian để liên kết với clip gốc.
Tương tự, một ebook hàng trăm trang hay buổi họp một giờ cần được chia thành đơn vị phù hợp. Giới hạn theo số trang hoặc số giây không thay thế giới hạn tổng token của request.[3]
4. RAG đa phương thức: embedding chỉ là một lớp trong hệ thống
Trong RAG, lớp truy hồi chọn dữ liệu liên quan để mô hình sinh câu trả lời có thêm ngữ cảnh. Google xem RAG là một ứng dụng phổ biến của embedding.[3]
Một kiến trúc tham khảo cho kho tri thức đa phương thức:
- Tiếp nhận dữ liệu: bài viết, ảnh, PDF, audio và video.
- Chia đoạn: theo mục tài liệu, nhóm trang, đoạn audio hoặc clip ngắn; giữ liên kết với nguồn gốc.
- Tạo embedding: dùng cùng model và cấu hình chiều nhất quán cho những vector cần so sánh.
- Lưu vector và metadata: nguồn, trang, thời gian bắt đầu/kết thúc, ngày cập nhật, quyền truy cập.
- Truy hồi: embed truy vấn, tìm ứng viên tương tự, lọc theo metadata và quyền người dùng.
- Trả lời có căn cứ: gửi nội dung gốc được truy hồi cho mô hình sinh và yêu cầu dẫn đúng trang hoặc mốc thời gian.
Đây là đề xuất thiết kế, không phải một tính năng tự động hoàn thành chỉ bằng lời gọi API. Embedding không quản lý quyền truy cập thay bạn, không bảo đảm dữ liệu còn đúng và cũng không tự xác minh câu trả lời.
Với một cổng kiến thức như AIDaLat, hướng thử nghiệm hợp lý là bắt đầu từ bài viết và tài liệu kỹ thuật, sau đó bổ sung slide hoặc video. Nên so sánh với tìm kiếm từ khóa hiện có, thay vì thay toàn bộ hệ thống trước khi có số đo.
5. Vector nhỏ hơn: tiết kiệm dung lượng, nhưng phải đo chất lượng
Gemini Embedding 2 sử dụng Matryoshka Representation Learning (MRL), cho phép điều chỉnh độ dài vector bằng output_dimensionality. Mặc định là 3.072 chiều; model tự chuẩn hóa cả các vector có chiều giảm như 768 hoặc 1.536.[3]
Ví dụ tính toán riêng cho phần số liệu vector: với 1 triệu vector lưu dưới dạng float32, 3.072 chiều cần khoảng 12,288 GB theo đơn vị thập phân; 768 chiều cần khoảng 3,072 GB — giảm 75%. Đây chỉ là phép tính số vector × số chiều × 4 byte, chưa gồm index, metadata, bản sao và overhead của database.
Giảm chiều có thể tiết kiệm lưu trữ và chi phí xử lý downstream, nhưng không nên hứa “chất lượng không đổi” cho mọi bộ dữ liệu. Hãy đo Recall@k hoặc chất lượng kết quả với các truy vấn tiếng Việt thực tế trước khi quyết định.
Cũng cần phân biệt: giảm số chiều vector không đồng nghĩa giảm hóa đơn token đầu vào của Gemini API. Hai phần chi phí này khác nhau.
6. Giá Gemini API: nên tính theo loại dữ liệu
Bảng dưới ghi lại giá Paid Tier của Gemini Developer API, đối chiếu ngày 06/10/2026; không phải báo giá cho mọi nền tảng hoặc nhà cung cấp.[4]
| Đầu vào | Standard / 1 triệu token | Batch / 1 triệu token |
|---|---|---|
| Văn bản | 0,20 USD | 0,10 USD |
| Hình ảnh | 0,45 USD | 0,225 USD |
| Âm thanh | 6,50 USD | 3,25 USD |
| Video | 12,00 USD | 6,00 USD |
Trang giá còn nêu các mức quy đổi Standard: khoảng 0,00012 USD/ảnh, 0,00016 USD/giây audio và 0,00079 USD/khung hình video. Batch có giá bằng một nửa Standard cho các dòng trên.[4]
Không nên lấy giá “mỗi phút video” bằng cách mặc định mọi khung hình của file đều bị tính: tài liệu embedding quy định cơ chế lấy mẫu tối đa 32 khung hình/video.[3] Dự toán thực tế còn phải tính số đoạn sau khi chia, các lần tạo lại embedding và các request kết hợp nhiều loại đầu vào.
Free Tier được liệt kê cho Standard, nhưng không có nghĩa sử dụng vô hạn. Trang giá ghi dữ liệu Free Tier có thể được dùng để cải thiện sản phẩm, còn Paid Tier ghi “No” ở mục đó; dự án xử lý dữ liệu nhạy cảm cần đọc thêm điều khoản áp dụng thay vì chỉ nhìn giá.[4]
7. Bắt đầu với Python: đúng model, đúng định dạng truy vấn
Cài SDK trong môi trường ảo trên Linux/WSL:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade google-genai
Thiết lập biến môi trường GEMINI_API_KEY bằng cơ chế quản lý secret của môi trường chạy, không ghi khóa vào source code. Ví dụ dưới dùng cấu trúc truy vấn tìm kiếm và tài liệu mà Google khuyến nghị cho text-only retrieval: query có task prefix, document có title và text.[3]
from google import genai
from google.genai import types

client = genai.Client()
config = types.EmbedContentConfig(output_dimensionality=768)

query = "task: search result | query: Cách xây dựng RAG đa phương thức?"
document = (
    "title: RAG đa phương thức | text: "
    "Hệ thống truy hồi văn bản, ảnh và các đoạn video liên quan "
    "trước khi tạo câu trả lời có dẫn nguồn."
)

# Hai lời gọi riêng: một vector query và một vector document.
query_response = client.models.embed_content(
    model="gemini-embedding-2", contents=query, config=config
)
doc_response = client.models.embed_content(
    model="gemini-embedding-2", contents=document, config=config
)

q = query_response.embeddings[0].values
d = doc_response.embeddings[0].values
assert len(q) == len(d) == 768

# Vector được model chuẩn hóa: dot product tương ứng cosine similarity.
score = sum(a * b for a, b in zip(q, d))
print("Số chiều:", len(q))
print("Độ tương tự:", score)
Đây là ví dụ cách gọi API, không phải benchmark. Một điểm số cho một cặp văn bản cũng chưa đủ đánh giá chất lượng tìm kiếm của toàn hệ thống.
Để tạo một vector chung cho ảnh và mô tả, có thể dùng đầu vào kết hợp như sau; Google minh họa cùng cơ chế này trong tài liệu.[3]
from pathlib import Path
from google import genai
from google.genai import types

client = genai.Client()
response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[
        "Một sản phẩm cần lập chỉ mục trong danh mục",
        types.Part.from_bytes(
            data=Path("san-pham.png").read_bytes(),
            mime_type="image/png",
        ),
    ],
    config=types.EmbedContentConfig(output_dimensionality=768),
)

# Các phần đầu vào trên được tổng hợp thành một embedding.
print("Số vector:", len(response.embeddings))
Google nhìn chung không khuyến nghị thêm task instruction vào phần văn bản của đầu vào đa phương thức tổng hợp: có trường hợp cải thiện nhưng cũng có trường hợp giảm hiệu quả. Đừng áp dụng máy móc prefix text-only cho mọi request có ảnh.[3]
8. Ba lỗi dễ mắc khi nâng cấp từ Gemini Embedding 001
Đổi tên model nhưng giữ nguyên vector cũ
Không gian embedding của gemini-embedding-001 và gemini-embedding-2 không tương thích. Google yêu cầu tạo lại embedding cho dữ liệu khi chuyển model; hai vector có cùng số chiều vẫn không vì thế mà so sánh được.[3]
Đề xuất triển khai an toàn: tạo index mới song song, chạy bộ truy vấn kiểm thử, chuyển lưu lượng khi đạt tiêu chí rồi mới loại index cũ.
Giữ tham số task_type như trước
gemini-embedding-001 dùng task_type, nhưng gemini-embedding-2 không hỗ trợ tham số này. Với tác vụ chỉ có văn bản, đưa hướng dẫn tác vụ trực tiếp vào chuỗi đầu vào theo mẫu chính thức.[3]
Tưởng danh sách input luôn trả nhiều vector
Với Embedding 2, nhiều input đưa trực tiếp vào một request có thể được tổng hợp thành một embedding, khác cách model 001 tạo embedding riêng cho từng chuỗi. Để tạo vector riêng, tài liệu hướng dẫn bọc từng input trong một đối tượng Content hoặc dùng Batch API.[3]
Nếu pipeline cần mỗi trang hoặc mỗi đoạn một vector, hãy kiểm tra số vector trả về trước khi ghi vào database. Lỗi này có thể không làm chương trình crash nhưng làm sai toàn bộ ánh xạ giữa vector và nguồn.
9. Nên dùng khi nào — và chưa nên dùng khi nào?
Đáng thử khi dữ liệu thực sự có nhiều định dạng: danh mục sản phẩm, thư viện hình/video, kho tài liệu có biểu đồ, hoặc trợ lý cần tìm bằng chứng nằm ngoài văn bản thuần.
Cần cân nhắc nếu nhu cầu chỉ là tra cứu mã chính xác, tên định danh hoặc một kho tài liệu nhỏ. Tìm kiếm từ khóa và hybrid search vẫn nên nằm trong bộ phương án để so sánh. Nếu yêu cầu offline hoặc không muốn gửi dữ liệu lên API, EmbeddingGemma là dòng sản phẩm khác đáng khảo sát cho embedding văn bản cục bộ.[2]
Trước khi đưa vào production, AIDaLat đề xuất kiểm tra:
- Một bộ truy vấn có đáp án tham chiếu, gồm tiếng Việt và thuật ngữ chuyên ngành.
- Recall@k, kết quả sai và khả năng dẫn về đúng trang/mốc thời gian.
- Chi phí tạo index lần đầu, cập nhật định kỳ và re-embed khi đổi model.
- Độ trễ truy vấn cùng quyền truy cập dữ liệu trước khi nội dung tới mô hình sinh.
- Số chiều, model, kiểu prefix và phiên bản dữ liệu được lưu trong metadata.
Kết luận: bước tiến ở tầng truy hồi, không phải lời hứa hiểu mọi thứ
Gemini Embedding 2 đem lại một nền tảng chung để tìm và tổ chức văn bản, hình ảnh, audio, video và PDF.[3] Với hệ thống RAG hoặc tìm kiếm có dữ liệu đa phương thức, đây là một khả năng đáng chú ý hơn việc chỉ tăng số token cho chatbot.
Nhưng giá trị sản phẩm không nằm ở một vector đơn lẻ. Nó nằm ở cách chia dữ liệu, lưu nguồn, kiểm soát quyền, đo chất lượng và trả kết quả có thể kiểm chứng. Embedding tốt giúp tìm đúng chỗ; hệ thống tốt mới giúp người dùng tin đúng điều.
Sources
[1] https://developers.googleblog.com/building-with-gemini-embedding-2 [2] https://ai.google.dev/gemma/docs/embeddinggemma [3] https://ai.google.dev/gemini-api/docs/embeddings [4] https://ai.google.dev/gemini-api/docs/pricing